ASIC山巔之城 百家爭鳴

全球AI算力競賽掀起浪潮


為了突破記憶體牆與百千瓦散熱瓶頸,谷歌、亞馬遜、微軟與Meta在新世代產品中,全數轉向高密度全液冷整機櫃交付。這場硬體型態革命不僅改寫雲端算力規則,還引爆台灣伺服器與散熱供應鏈的價值大升級。

文●魏聖峰

今年以前北美四大CSP業者砸下數千億美元資本支出建資料中心,很大一部分都轉化為Nvidia高達七五%毛利。今年四大CSP業者的自研晶片越來越成熟,逐漸扛起資料中心的核心運算主力。更關鍵的硬體變化是,AI ASIC競爭已全面升級為動輒100kW以上,並整合數十到上百顆晶片的全液冷整機櫃系統。從IP、晶圓代工、先進封裝到整機櫃液冷組裝,牽動全球半導體與伺服器供應鏈重組。

今年以前雲端資料中心內,大多以訓練數億參數基礎模型為主,從今年起全面跨入推論優先的商業變現模式。訓練一個前沿基礎模型要動用到數萬顆頂級晶片好幾個月,並屬於一次性的資本投入。反觀現在每天服務數十億用戶的搜尋摘要、程式碼生成、即時語音互動以及需要自主規劃和多步驟反思的代理式AI(Agentic AI),每次回答的背後都要生成數千甚至數萬個隱藏Token。根據業界統計,今年大型雲端機房已有超過七成的電力和算力消耗在推論的工作負載上。四大CSP業者在今年推出的自研ASIC上,直接定義用在推論。


訓練和推理合為一體的晶片

谷歌在去年發表的TPU v7(Ironwood)時直接定義為首款專為推論時代設計的TPU。微軟今年初發表的Maia 200與最新公布的Maia300中,也捨棄傳統訓練邏輯,全面針進行硬體最佳化,讓微軟在運行自家Copilot與OpenAI模型時,每瓦特電力產出的Token數量較商用GPU大幅提升一.七倍以上。亞馬遜把Trainium 3和Trainium 4定義為專為代理式AI與把極致Token經濟學打造的訓練和推理合為一體的主力晶片。Meta把MTIA 300/400/450/500定義為,拒絕將訓練晶片降維拿來做推論,全面轉向推論優先與兩年四代敏捷硬體。對CSP業者而言,訓練大語言模型固然重要,是在業界維持領先的必要條件,代理式AI才能吸引更多客戶,是將AI變現的最重要途徑。

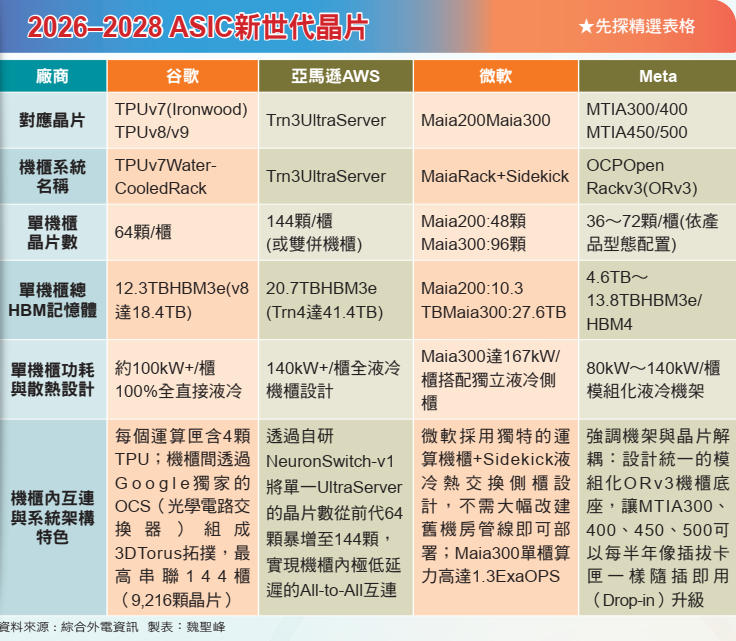
四大CSP業者從今年到二八年的技術藍圖,他們要解決的問題是記憶體牆,而非算力(FLOPS)。因為當模型生成一個新的Token,都必須將龐大的模型權重不斷膨脹的鍵值快取(KV Cache),從HBM邊運到運算核心。如果記憶體容量太小或頻寬不足,算力再高的晶片也只能處於閒置等待狀態。所以今年ASIC晶片普遍採用台積電三奈米製程加上HBM3e,包括谷歌TPU v7、AWS Trainium 3、微軟Maia 200,將單顆記憶體推升到144∼216GB區間,頻寬落在4.9∼7.4TB/s。到了明年量產的下一代產品,將進一步推升到二奈米加上HBM4(288GB),包括谷歌TPU v8、AWS Trainium 4與微軟Maia 300。其中,微軟Maia300透過搭載八顆HBM4堆疊,率先將單顆晶片記憶體頻寬推升到18TB/s,較前代暴增超過二.五倍,來正面挑戰長文本(Longcontext)與即時多模態推論的頻寬極限。

四大CSP的ASIC設計都朝向先進製程與高容量HBM邁進,並放棄過去的單張加速卡或單台2U/4U伺服器的交付模式,而是全數走向整機櫃化(Rack-Scale System),這並非單純為了外觀整齊或方便管理,而是被大模型記憶體容量、高速銅線物理限制、上百千瓦級散熱以及供電等五個硬體物理定律給逼出來的結果。首先,在混合專家模型(GPT-5、Claude 4、Genini 3)與長上下文的推論時代,一次運算往往需要10TB到25TB以上的HBM。

物理極限走向機櫃化

然而,受限台積電CoWoS封裝晶圓曝光面積極限,使用最先進製程的谷歌TPU v7、AWS Trainium 4或微軟Maia 300,單顆晶片最多也只能封裝192GB∼288GB的HBM。解決方案就是必須把四八顆、六四顆、九六顆甚至一四四顆ASIC用超高網路綁在一起,讓它們在軟體平台上看起就像是用同一顆擁有20TB記憶體的超大晶片。這種需要數十顆晶片共享記憶體的架構稱為垂直擴展(Scale-up)。乘載這個擴展領域最小的物理容器,就是一個標準伺服器機櫃。

要把這麼多至少六四顆∼一四四顆晶片連成一顆大腦,晶片與晶片間的傳輸速率將推升到22G甚至448G SerDes,晶片間互聯總頻寬也要高達數TB/s。由於銅纜線傳輸訊號最多只能到兩公尺,超過這距離訊號會嚴重衰減,要把這麼多顆晶片塞進同一機櫃內,並用銅纜背板直接互連。一旦分散到不同機櫃,就必須把訊號轉為光傳輸,並使用到光纖和800G/1.6T收發模組,這將大幅增加成本。谷歌自研的TPU已超過十年,並從今年四月上市的TPU v7(Ironwood)將單顆晶片HBM 3e推升到192GB,並透過獨家開發的光電路交換器(OCS),把九二一六顆晶片串成單一邏輯叢集,成為支撐Gemini模型家族的核心引擎。預計到二七年底、二八年要部署的TPU v9(Pumafish),更將採用開放式Scale-up Ethernet(擴展型乙太網路)與CPO(共同封裝光學),除自家使用外,還積極向Anthropic、大型主權基金與超大規模AI新創直接出租或銷售TPU算力。

在散熱與電力部分,為了配合兩公尺銅線極限,把六四∼一四四顆晶片塞進一個機櫃時,單一機櫃的總功耗會直接飆升到100kW到167W。這與傳統伺服器單一機櫃功耗只有10kW∼15kW、單靠機房吹冷氣與風散就能散熱的情況大不相同,微軟最新Maia 300單顆功耗就達900W。100kW以上就必須採用全液冷管路,並採用高壓直流供電。


迭代縮短必須模組化

現在CSP大廠晶片迭代縮短到一年一代,甚至Meta還以半年為一代的週期,把整機櫃模組化就是最快速和節省成本的模式。Meta採用OCP Orv3開放架構、微軟的Maia Rack+Sildekick側架,他們把機櫃基礎設施與運算匣分開。當下一代二奈米ASIC推出來時,只需要把舊的運算匣拔出來、插進新晶片運算匣,就能夠在幾天內完成數萬顆晶片的升級。

過去CSP自研晶片,仰賴掌握高速SerDes IP與先進封裝經驗的博通。但博通強勢要求高達六∼七成的毛利率定價,讓這些追求成本效益的CSP業者開始培養第二供應鏈,甚至要把更多前端設計收回自研,僅將後端時體設計與量產管理交由晶圓廠生態系夥伴負責,聯發科(2454)、世芯KY(3661)、創意(3443)與Marvell就被CSP納入合作夥伴。聯發科已奪下二七年量產TPU v8i(推論晶片)訂單,成為跨足雲端AI ASIC的最大突破。世芯-KY參與AWS Trainium 3量產,更鎖定二七年底到二八年的二奈米Trainium 4超大型封裝專案,是台廠AIASIC設計服務龍頭。創意有台積電子公司優勢,深度參與微軟Maia系列和多家CSP的先進封裝與HBM裸晶(Base Die)專案。美系Marvell在微軟Maia 300、AWS Traiium和谷歌外部記憶體池晶片(Memory Pool)中全面擴大市占率。

… 本文摘錄自 先探投資週刊 2026/10月 第2427期
閱讀完整內容
先探投資週刊2026/10月 第2427期

本文摘錄自‎

ASIC山巔之城 百家爭鳴

先探投資週刊

2026/10月 第2427期